
Az Anthropic innovatív politikája a katasztrofális AI kockázatok megfékezésére
A technológiai fejlődés korában az Anthropic a felelősségvállalás jelzőfényeként lép fel és olyan politikát vezet be, amelynek célja, hogy egyensúlyt teremtsen az AI fejlődése és a biztonság között.
2 perc olvasás
-
Az Anthropic kiadja a Responsible Scaling Policy-t (RSP) a nagy léptékű AI-val kapcsolatos kockázatok mérséklése érdekében.
-
A politika bevezeti az AI biztonsági szinteket a különböző AI-rendszerek potenciális kockázatainak kezelésére.
Ha többet akarsz tudni, kövess minket Facebookon! -
Az Anthropic hangsúlyozza a politika fejlődő jellegét és a független felügyelet fontosságát.
A Claude chatbotjáról ismert Anthropic az új Responsible Scaling Policy (RSP) segítségével döntő lépést tett a mesterséges intelligencia felelős növekedésének biztosítása felé. Ez a politika proaktív válasz az AI-által jelentett potenciális katasztrofális kockázatokra és olyan forgatókönyvekkel foglalkozik, amelyekben az AI hatalmas pusztítást vagy pénzügyi veszteséget okozhat.
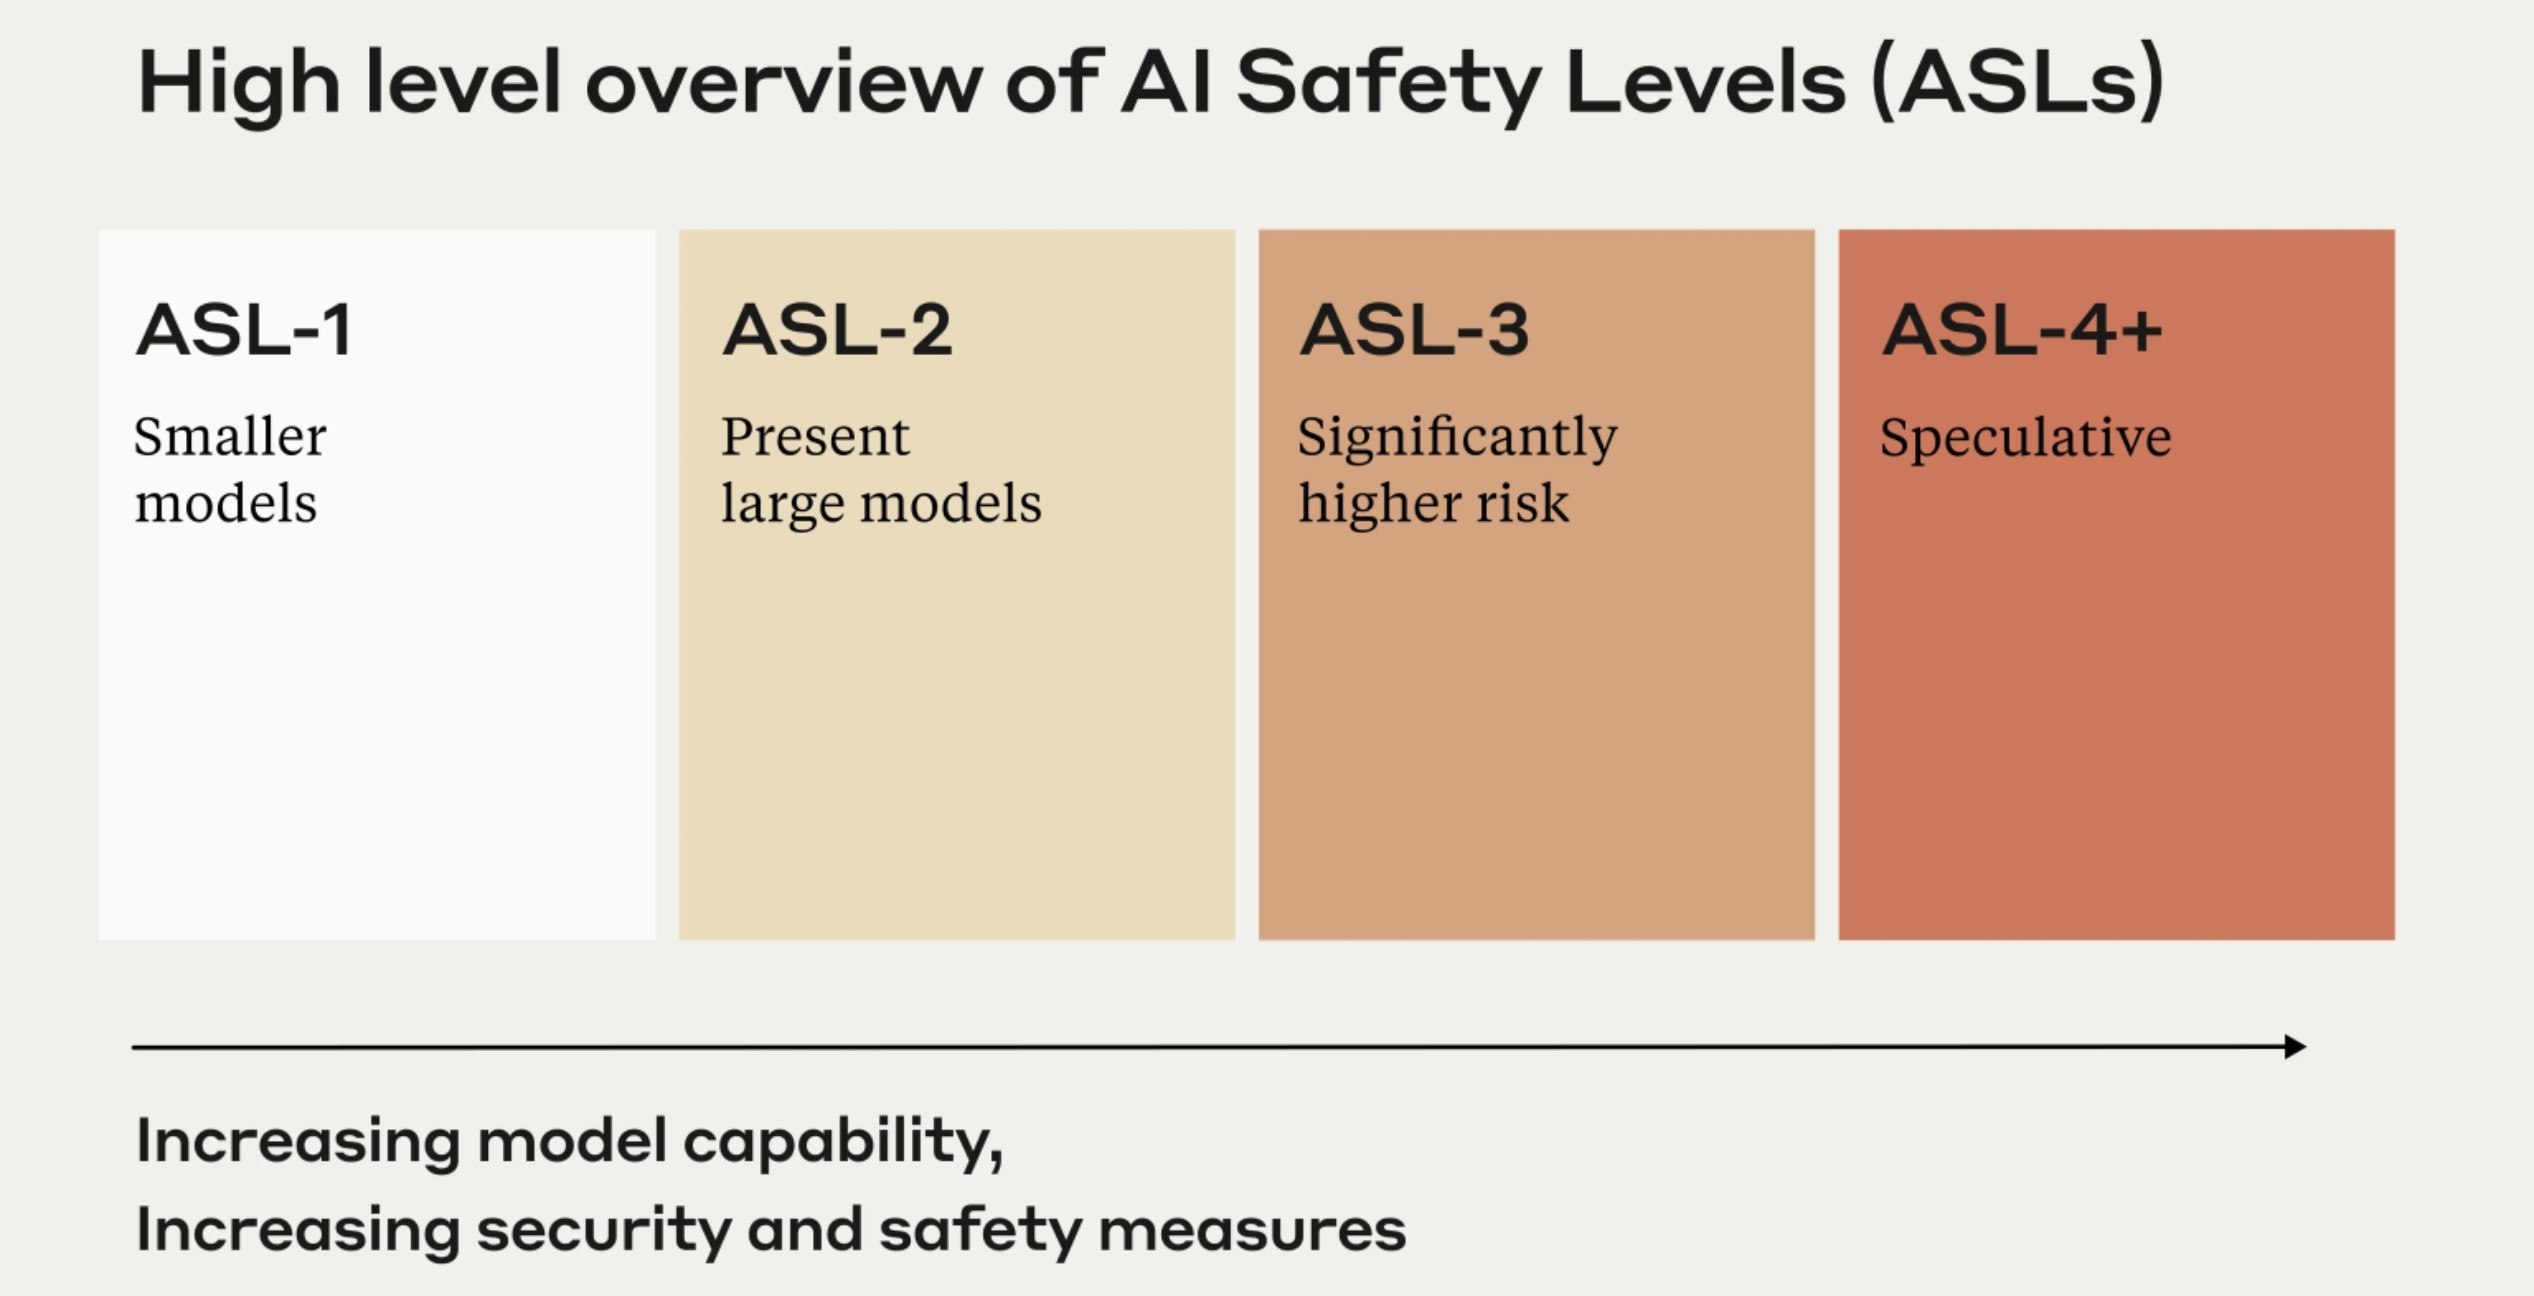
Az RSP az Anthropic elkötelezettségét bizonyítja a fejlett mesterséges intelligencia modellekkel kapcsolatos növekvő veszélyek megfékezése mellett. Ennek a politikának a középpontjában az AI biztonsági szintek (ASL) állnak, egy olyan kockázati kategorizálási rendszer, amelyet az Egyesült Államok kormányának biológiai biztonsági szintjei ihlettek. Az ASL-0-tól (alacsony kockázat) az ASL-3-ig (magas kockázat) terjedő szintek célja, hogy a különböző mesterséges intelligencia rendszerek potenciális veszélyeit aprólékos értékelés, telepítés és felügyelet révén felmérjék és kezeljék.
Sam McCandlish, az Anthropic társalapítója hangsúlyozta a politika dinamikus jellegét, megjegyezve, hogy az a tapasztalatok és a visszajelzések alapján alkalmazkodik. A vállalat víziója, hogy a versenynyomást kulcsfontosságú biztonsági kérdések megoldásává alakítsa. Ezáltal a biztonságosabb, kifinomultabb mesterséges intelligencia rendszerek fejlesztése új képességek felszabadításához vezet, nem pedig elhamarkodott, ellenőrizetlen növekedéshez. Ez a megközelítés azonban nem jár kihívások nélkül. McCandlish elismeri a kockázatok értékelésének bonyolultságát, különösen akkor, ha a modellek elrejthetik valódi képességeiket.
Az Anthropic bejelentése a mesterséges intelligencia ágazatban egyre növekvő ellenőrzés és szabályozás közepette történik. Az OpenAI-ban gyökerező és az olyan óriások, mint a Google jelentős támogatását élvező Anthropic kiemelkedik az AI biztonság és összehangolás terén. A Claude nevű AI chatbotjuk jól példázza a biztonság és az etika iránti elkötelezettségüket, mivel az „alkotmányos AI” megközelítést alkalmazza a káros felszólítások ellensúlyozására. Ez a módszer, amely a felügyelt és a megerősítő tanulást kombinálja, ellenőrzöttebb AI viselkedést kínál, ami jelentős ugrást jelent az etikus és biztonságos AI-rendszerek fejlesztése terén.
AIWORLD · ÉRTSD, AMI KÖVETKEZIK.További hírek
ÉRDEMES TOVÁBBADNI
Vigyél másokat is képbe.


