Az AI képzésével kapcsolatos vita: Szerzők beperelik az OpenAI-t és a Meta-t szerzői jogok megsértése miatt
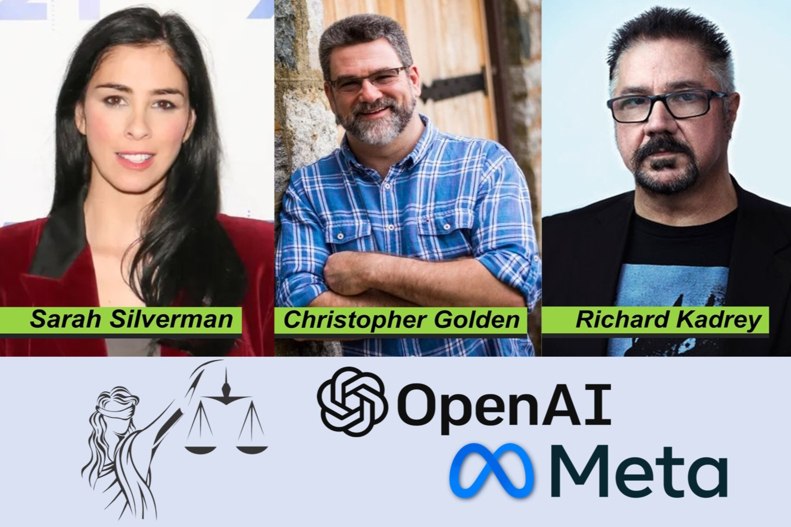
Egy úttörő perben Sarah Silverman, Christopher Golden és Richard Kadrey szerzők az OpenAI és a Meta technológiai óriáscégekkel szállnak szembe a szerzői jogok állítólagos megsértése miatt.
2 perc olvasás
-
Sarah Silverman, Christopher Golden és Richard Kadrey szerzők beperelik az OpenAI-t és a Metát szerzői jogok állítólagos megsértése miatt, azt állítva, hogy műveiket a hozzájárulásuk nélkül használták fel az AI-tréningben.
-
A perben azt állítják, hogy a ChatGPT és a LLaMA programját az ő műveiket is tartalmazó adathalmazokon képezték ki, amelyeket "árnyékkönyvtár" weboldalakról szereztek be.
Ha többet akarsz tudni, kövess minket Facebookon! -
A szerzők többek között törvényes kártérítést, nyereség-visszatérítést követelnek egy olyan ügyben, amely jelentős hatással lehet az AI-iparágra.
Egy mérföldkőnek számító ügyben Sarah Silverman, Christopher Golden és Richard Kadrey neves szerzők jogi lépéseket tesznek az OpenAI és a Meta technológiai óriáscégek ellen. A szerzők azt állítják, hogy szerzői jogvédett műveiket engedély nélkül használták fel a vállalatok mesterséges intelligencia modelljeinek, a ChatGPT-nek és az LLaMA-nak a kiképzéséhez. A keresetek szerint ezeket a modelleket az ő műveiket is tartalmazó adathalmazokon képezték ki, amelyeket többek között olyan "árnyékkönyvtári" webhelyekről szereztek be, mint a Bibliotik, a Library Genesis és a Z-Library.
A szerzők bizonyítékokat mutattak be arra vonatkozóan, hogy a ChatGPT kérésre képes összefoglalni a könyveiket, ami szerintük sérti a szerzői jogaikat. Például Silverman "Bedwetter" és Golden "Ararat" című könyvét a ChatGPT összefoglalja. A Meta elleni perben azt állítják, hogy a szerzők könyvei hozzáférhetőek voltak a februárban bevezetett LLaMA modellek képzéséhez használt adathalmazokban. A felperesek szerint ezek az adathalmazok tiltott eredetűek, rámutatva az egyik ThePile nevű forrásra, amelyet egy EleutherAI nevű cég állított össze, és amely szerintük "a Bibliotik privát nyomkövető tartalmának másolatából" állt össze.
A szerzők azt állítják, hogy "nem járultak hozzá ahhoz, hogy a szerzői joggal védett könyveiket tréninganyagként használják" az AI-modellekhez. Keresetük hat pontban tartalmaz különböző szerzői jogok megsértését, gondatlanságot, jogalap nélküli gazdagodást és tisztességtelen versenyt. Törvényes kártérítést, a nyereség visszaszolgáltatását és egyebeket kérnek. Ez az ügy potenciálisan újradefiniálhatja a szerzői jog határait a mesterséges intelligencia korában, és kimenetelét a szerzők, a kiadók és a technológiai vállalatok egyaránt figyelemmel kísérik majd.
AIWORLD · ÉRTSD, AMI KÖVETKEZIK.További hírek
ÉRDEMES TOVÁBBADNI
Vigyél másokat is képbe.